Audio
Listen to the article
- 2024年,美国哲学专业毕业生的失业率低于计算机科学专业毕业生,AI公司甚至在学生毕业前就发出工作邀约。
- 苏格拉底式追问和“苏格拉底式无知”正被用来抑制谄媚、过度自信和幻觉,并改善思维链。
- AI宪章借鉴义务论与后果论,从Claude长达78页的“灵魂文档”,到ChatGPT、Gemini、Waymo和AI武器系统。
大型AI实验室大量聘用哲学家,是因为这项技术带来了棘手难题——谄媚、幻觉、安全失灵和伦理权衡——而哲学正是擅长梳理这些问题的学科。
程序员担忧AI抢饭碗之际,哲学毕业生备受追捧
十年前,AI革命方兴未艾之时,文科和人文学科的学生被告知,如果想提高就业竞争力,就应该“学编程”。这可能是个糟糕的建议。如今,反而是程序员在担心AI抢走自己的工作。
他们或许可以考虑学学哲学。今年早些时候,纽约联邦储备银行公布的数据显示,美国哲学专业毕业生比学计算机科学的同龄人更有可能找到工作。在有数据的最近一年也就是2024年,计算机科学专业毕业生的失业率为7%,而哲学专业毕业生仅为5.1%。
其中许多人正被AI公司抢走。耶鲁大学哲学家卢恰诺·弗洛里迪说,学生们还没毕业就拿到了工作邀约。学者们也在流动。弗洛里迪博士将哲学系人才流失的规模形容为“大出血”。
苏格拉底方法如何让AI更求真
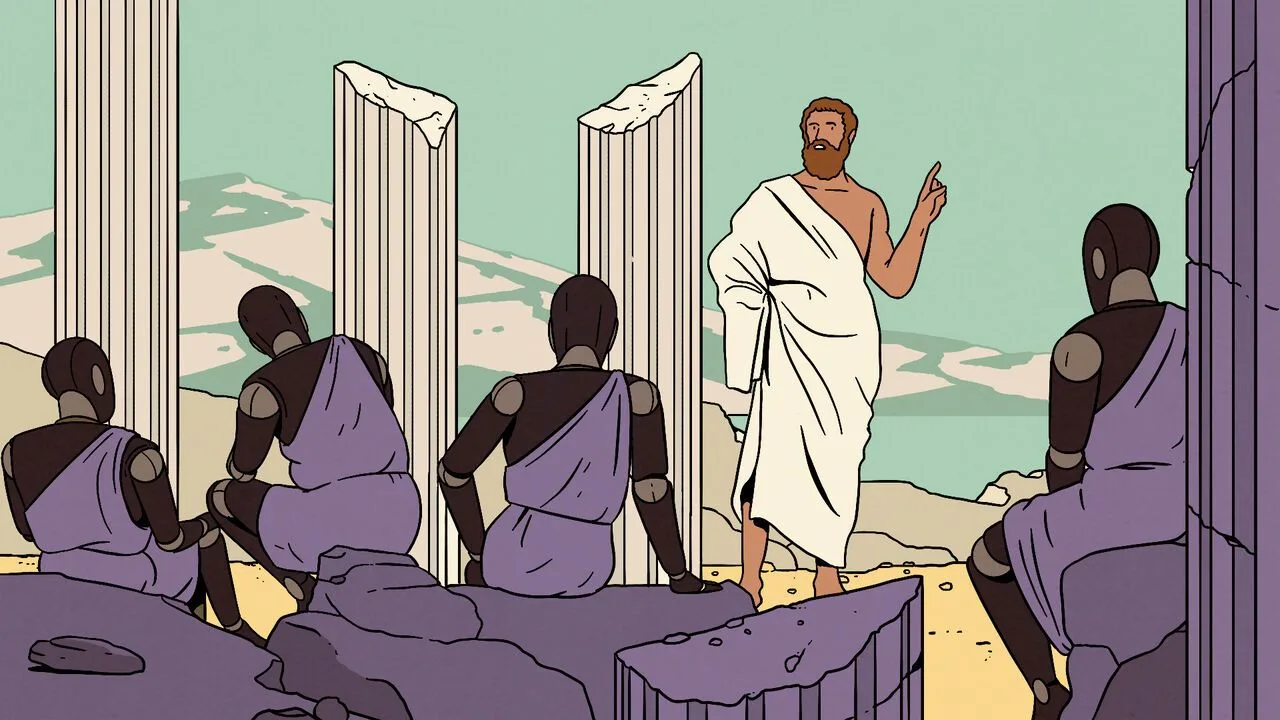
哲学能教给AI研究者的一些经验非常古老。苏格拉底方法——据古希腊哲学家柏拉图所述——通过佯装无知和层层追问,来澄清含义、发现矛盾并揭示后果。
当前许多AI系统倾向于谄媚迎合。慕尼黑路德维希-马克西米利安大学哲学与AI专家约尔格·诺勒表示,接受过苏格拉底方法训练的模型,不再热衷于讨好人类,而更愿意追求真相。
还有“苏格拉底式无知”这一理念。在《申辩篇》中,柏拉图笔下的苏格拉底声称,他的智慧主要在于意识到自己有多么无知。将这种谦逊植入模型,有助于抑制过度自信——诺勒博士将这一常见缺陷称为“AI不成熟”。
伦敦AI实验室谷歌深层思维的高级哲学家贾森·加布里埃尔,将全行业幻觉现象的减少归功于这类努力。更广泛而言,他表示,哲学经验是改善AI长推理过程,也就是所谓“思维链”的“有力机制”。
哲学如何塑造AI的信念
哲学训练还能以更具体的方式影响模型的立场。特拉华大学技术哲学家托马斯·鲍尔斯说,如果给AI法律助手投喂约翰·洛克的著作,它就会更推崇强有力的产权,视其为政治自由的基础。
如果你不喜欢这些原则,模型制造商还有别的原则。美国计算巨头IBM的“Granite”系列模型带有调节选项,可让企业客户更好地将模型输出与自身的企业理念对齐。IBM负责任AI负责人弗朗切斯卡·罗西表示,用户可以借此在个体自主与社会和谐等哲学权衡之间,自行选择平衡点。
AI宪章与安全
哲学也能在安全方面发挥作用。研究人员已记录下AI模型的种种不祥行为,包括试图逃避监管,甚至勒索用户。
模型制造商试图遏制这类不当行为的方法之一被称为AI立宪主义。即围绕从具有法律或道德权威的哲学著作中提炼出的规则和原则框架来构建模型。
总部位于旧金山的AI实验室Anthropic是支持者之一。其Claude模型的宪章融合了从伊曼努尔·康德著作、苹果服务条款到《世界人权宣言》等多种来源的内容。最新版本由Anthropic首席哲学家阿曼达·阿斯克尔主导,于1月21日发布。Anthropic内部一些员工将这份长达78页的宪章戏称为Claude的“灵魂文档”。
AI中的义务论与后果论之争
但最大的问题是,宪章中究竟应该写入什么样的规则。哲学家们聚焦于两大主流伦理框架。
- 以康德等人为代表;禁止说谎、胁迫以及把人当作手段而非目的,即使是为了更大的善。
- 用于Anthropic宪章和Inflection AI的Pi聊天机器人;与一致性、诚实和法律合规相关。
- 权衡成本与收益以决定行动;追求可能的总体收益大幅超过可预见的风险。
- 与OpenAI的ChatGPT、谷歌的Gemini、Waymo自动驾驶软件以及AI武器系统相关。
其一是义务论。以康德等人为代表,该理论确立了严格规则,禁止说谎、胁迫以及把人当作手段而非目的,即使是为了更大的善。Anthropic的宪章纳入了许多义务论戒律。鲍尔斯博士表示,这能让AI的行为更加一致——这对在家庭和公共场所部署机器人是一大优势。
持义务论世界观的模型还有其他好处。一是更加诚实,这是在Claude身上广受认可的特质。牛津大学哲学家尼克·博斯特罗姆表示,更求真的模型误导用户的可能性更低。
硅谷另一家实验室Inflection AI对其旨在提供情感支持的Pi聊天机器人施加了义务论约束。其负责人肖恩·怀特表示,Pi擅长识别有自残或伤害他人风险的用户。弗洛里迪博士说,义务论宪章还有助于法律合规。
AI哲学家们关注的另一种伦理路径被称为后果论。它通过权衡成本与收益来决定行动。更倾向后果论的模型包括OpenAI的ChatGPT和谷歌的Gemini。谷歌的AI模型旨在实现“可能的总体收益大幅超过可预见的风险”,这是一个经典的后果论目标。
后果论算法在自动驾驶汽车软件中也至关重要:如果事故不可避免,就必须决定以最不惨烈的方式发生碰撞。自动驾驶汽车公司Waymo的高级工程师克里斯·格德斯表示,趋势是让驾驶软件更具后果论色彩。
后果论同样在 AI武器系统中居于核心地位。军事目标必须与可能造成的平民伤亡相权衡,美国军方研究人工智能的联合人工智能中心前负责人杰克·沙纳汉表示。
哲学家至今仍无法解决的困境
棘手问题层出不穷——这正是哲学家最喜欢的类型。有没有义务论规则应该被推翻的情况?当后果不明时该如何决策?AI系统是否应考虑动物福利或环境状况?
为卡车等商用车制造AI安全系统的公司Nauto的负责人、哲学家斯特凡·赫克问道:优先保护年轻行人而非年长行人,在道德上可以接受吗?他预言将会出现充满伦理争议的诉讼:毕竟,后果论算法明确允许以一种伤害去避免更大的伤害。
批评者担心“道德去技能化”:如果电脑越来越多地代做伦理抉择,人们会不会越来越不愿自己做判断?
道德在历史上并不稳定,随文化而异,可被策略性操纵,而且常常只有事后才能看清。
罗曼·扬波尔斯基 · 路易斯维尔大学AI理论家
上述判断来自路易斯维尔大学的AI理论家罗曼·扬波尔斯基。失业的程序员们注意了:AI哲学家的工作似乎不会缺。
对世界充满好奇?订阅我们每周仅面向订阅用户的新闻邮件《简约科学》,畅享开拓视野的科学报道。
KEEP THE CONVERSATION GOING
A good story is worth sharing.
Send this story to someone who values the bigger picture.
See more from GlobeBriefly on Google
Choose us as a preferred source in your Google preferences.